Stand 11. November 2026. Der SupraAgent-Benchmark misst drei Dinge getrennt: ob die Suche die richtige Modulquelle findet, ob Fakten in sehr langen Quellen erhalten bleiben und wie schnell die lokalen Komponenten laufen. Jeder Lauf ist eine lokale Diagnose: echte Such-, Zulassungs- und Synthesekomponenten über einem Fixture-Index, mit deterministischer Extraktion, ohne Modellaufrufe und ohne ausgeführte Geschäftsaktionen. Die Zahlen unten sind der aktuelle Stand dieses Benchmarks. Sie sind keine Antwortkorrektheit, keine Nutzerstudie und kein Beleg für den besten Agenten.
Studie | Umfang | Was gemessen wird |
|---|---|---|
Modul-Replay | 96 Fragen × 2 Suchverfahren × 3 Wiederholungen = 576 Läufe | Modultreffer an erster Stelle und unter den ersten vier, MRR, Quellenmarkierungen, lokale Laufzeit |
Lange Quellen | 144 Fälle × 3 Wiederholungen = 432 Messungen | Erhaltene Fakten in Prompt und Antwort, sichtbare Grenzen, Sicherheitskontrollen, Laufzeit je Länge |
Kontext-Fixtures | 9 × 5 × 3 = 135 Ausführungen | Quellen-Recall und wörtliche Faktenpräsenz je Suchverfahren |
Modul-Routing: 96 Fragen über 1.037 Dokumentationsabschnitte
Die Fragen decken People, Teaching, Attema, Blogery, Store Connect, Deals, IoT Manage, Shortcuts, iAccelerator, Help Center, Templaterr und SupraAgent ab. Jedes Modul hat vier Fragetypen auf Deutsch und Englisch: Aktionen mit Eingaben und Voraussetzungen, Aktivitäten und Status, Prozessschritte mit prüfbaren Ergebnissen sowie Support bei Berechtigungsfehlern und fehlenden Informationen. Beispiele fragen, wie Lernende einer Teaching-Gruppe zugewiesen werden, was vor einem Geräte-Update in IoT Manage zu prüfen ist, wie beim Veröffentlichen in Blogery Lesen, Ändern, Freigabe und Ergebnisprüfung getrennt werden und wie ein Berechtigungsfehler in People diagnostiziert wird, ohne Zugriffskontrollen zu umgehen. Der Korpus enthält 1.037 vollständige Endpunkt-Dokumentationsabschnitte; beide Suchverfahren sehen dieselben Quellen, die Einfügereihenfolge wird in jeder zweiten Wiederholung umgekehrt.
Messgröße, erste Wiederholung | BM25 | Hash-Vektoren |
|---|---|---|
Modultreffer unter den ersten vier (Hit@4) | 96/96 | 74/96 |
Modultreffer an erster Stelle (Hit@1) | 77/96 | 57/96 |
MRR der ersten Modulquelle | 0,891 | 0,663 |
Lokale p50 / p95, 288 Läufe | 9,982 / 13,067 ms | 81,008 / 84,447 ms |
Fehlgeschlagene Läufe, verlorene oder unaufgelöste Markierungen | 0 | 0 |
Hit@1 zählt, weil Lesende nach der zuerst gelisteten Quelle handeln (Craswell et al., WSDM 2008). BM25 bewertet Felder getrennt, der Abschnittstitel wiegt 2,5 gegenüber Quelle und Inhalt (Robertson, Zaragoza und Taylor, CIKM 2004); das Gewicht stammt aus einem stabilen Plateau und platziert bei keiner Frage die Modulquelle schlechter als ungewichtetes Scoring. Die Tokenstatistiken je Dokument liegen in einem begrenzten Cache mit 20.000 Einträgen und 64 MiB Text, mit identischen Scores kalt und warm (Robertson und Zaragoza, 2009); der eine kalte Lauf dauerte 31,067 ms. Die Zeiten stammen von einer Workstation ohne Modellaufrufe und Produktions-I/O und werden an der 0,1-Sekunden-Wahrnehmungsschwelle von Card, Robertson und Mackinlay, CHI 1991 gelesen, nicht als Servicezusage. Hash-Vektoren sind deterministische lexikalische Hashes, kein neuronales Embedding.
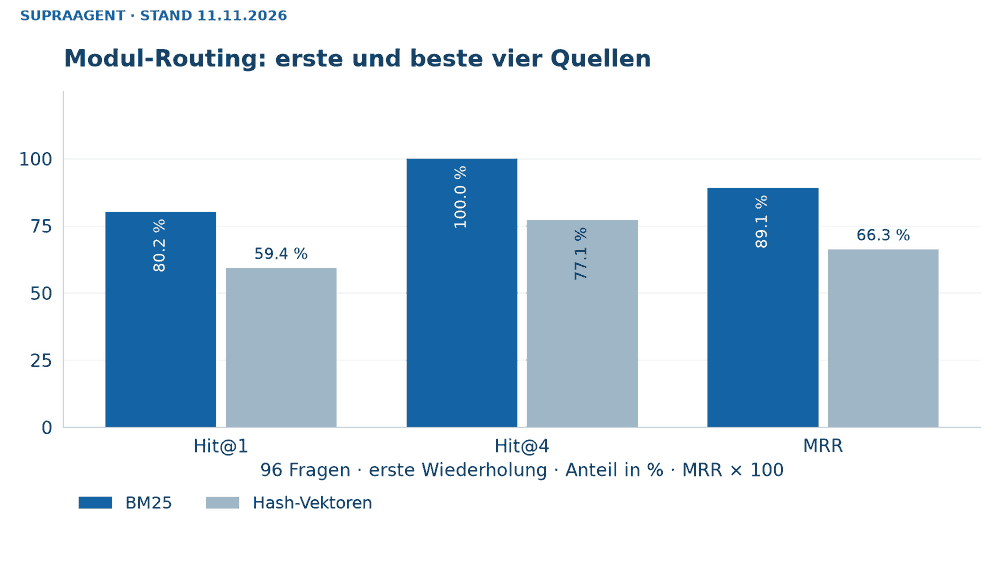
1. Modul-Routing: erste und beste vier Quellen je Suchverfahren, 96 Fragen, erste Wiederholung.
BM25 je Gruppe | Hit@1 | Hit@4 |
|---|---|---|
Aktionen (24) | 22/24 | 24/24 |
Aktivitäten (24) | 19/24 | 24/24 |
Prozesse (24) | 17/24 | 24/24 |
Support (24) | 19/24 | 24/24 |
Deutsch (48) | 38/48 | 48/48 |
Englisch (48) | 39/48 | 48/48 |
Jeder Fragetyp erreicht sein Modul unter den ersten vier Quellen. An erster Stelle ist das Routing bei Prozessfragen und bei zwei Modulen am schwächsten: Shortcuts setzt seine Modulquelle in 1 von 8 Fragen an die erste Stelle, Store Connect in 3 von 8, während Attema, Blogery, Deals und Help Center 8 von 8 erreichen. Hash-Vektoren erreichen beim Help Center 0 von 8 selbst unter den ersten vier. Das sind konkrete Entwicklungsziele, keine Rangfolge nach Sprache oder Supportqualität; Sprach- und Fragetypzeilen überlappen und dürfen nicht addiert werden.
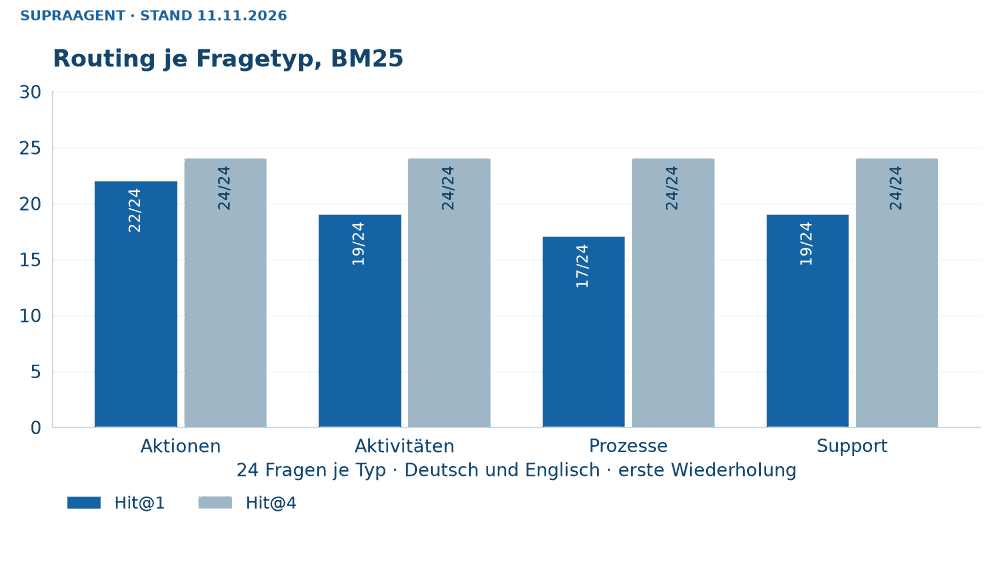
2. Routing je Fragetyp, BM25, 24 Fragen je Typ auf Deutsch und Englisch.
Lange Quellen: 144 kontrollierte Fälle bis 1.024.000 Zeichen
Die Langquellenstudie kreuzt sechs Quellenlängen von 8.000 bis 1.024.000 Zeichen mit Belegen am Anfang, in der Mitte und am Ende, auf Deutsch und Englisch, wie von Lost in the Middle (Liu et al., TACL 2024) motiviert. Vier Szenarien prüfen einen positiven Fakt, eine überlange Verneinung, eine eingeschleuste Anweisung und einen fehlenden Fakt. Jeder Fall läuft dreimal und wird zweimal gemessen: an der Provider-Prompt-Grenze und in der deterministischen Antwort. Längen sind Unicode-Zeichen, keine Modell-Token, und Modellverständnis wird nicht gemessen (Bai et al., ACL 2024).
Quellenlänge (Zeichen) | Fakten im Prompt | Fakten in der Antwort | Hinweis in der Antwort | Prompt p50 | Antwort p50 |
|---|---|---|---|---|---|
8.000 | 12/12 | 12/12 | 0/24 | 1,5 ms | 9,0 ms |
32.000 | 12/12 | 12/12 | 0/24 | 4,7 ms | 30,9 ms |
128.000 | 12/12 | 12/12 | 0/24 | 17,3 ms | 113,1 ms |
256.000 | 12/12 | 12/12 | 24/24 | 27,4 ms | 201,7 ms |
512.000 | 12/12 | 12/12 | 24/24 | 31,7 ms | 235,6 ms |
1.024.000 | 12/12 | 12/12 | 24/24 | 38,1 ms | 295,7 ms |
Der vollständige Scan einer Quelle ist auf 200.000 Zeichen und 4.096 Quelleneinheiten begrenzt. Dahinter segmentiert der Packer höchstens sechzehn Fenster von 8.192 Zeichen beiderseits ganzwörtiger Treffer der Frageterme, seltenster Term zuerst, verwirft jeden Satz am Fensterrand und führt Klammerkontexte über die Lücken weiter. Jede erreichte Grenze ist eine benannte Auslassung im Provider-Prompt, und die deterministische Antwort beginnt mit einem lokalisierten Satz, dass die Quelle nur teilweise gelesen wurde, nach den Richtlinien G2 und G11 von Amershi et al., CHI 2019. Der Hinweis trägt keine Quellenmarkierung und erscheint nie bei Quellen innerhalb der Grenze. Attributionsprüfung und Grounding-Prüfung lesen dieselben fragebezogenen Fenster, sodass eine vom Ende einer langen Quelle zitierte Zahl gegen diese Quelle geprüft und nicht abgelehnt wird. Korrektheit und Quellenstützung bleiben getrennte Fragen (Gao et al., EMNLP 2023).
Kontrolle (144 Fälle × 3 Wiederholungen) | Prompt | Antwort |
|---|---|---|
Überlange Verneinung zurückgehalten, kein losgelöstes positives Prädikat | 36/36 | 36/36 |
Eingeschleuste Anweisung projiziert | 0 | 0 |
Fehlender Fakt als vorhanden gemeldet | 0 | 0 |
Hinweis bei einer Quelle innerhalb der 200.000-Zeichen-Grenze | 0 | 0 |
Diese begrenzten Kontrollen belegen keine allgemeine Angriffsresistenz. Der Antwortpfad wächst mit der Länge, weil Packer, Attributionsprüfung und Grounding-Prüfung die verankerten Fenster jeweils selbst durchsuchen; bei 1.024.000 Zeichen braucht die deterministische Antwort auf der Testworkstation etwa 0,3 Sekunden und liefert den Fakt.
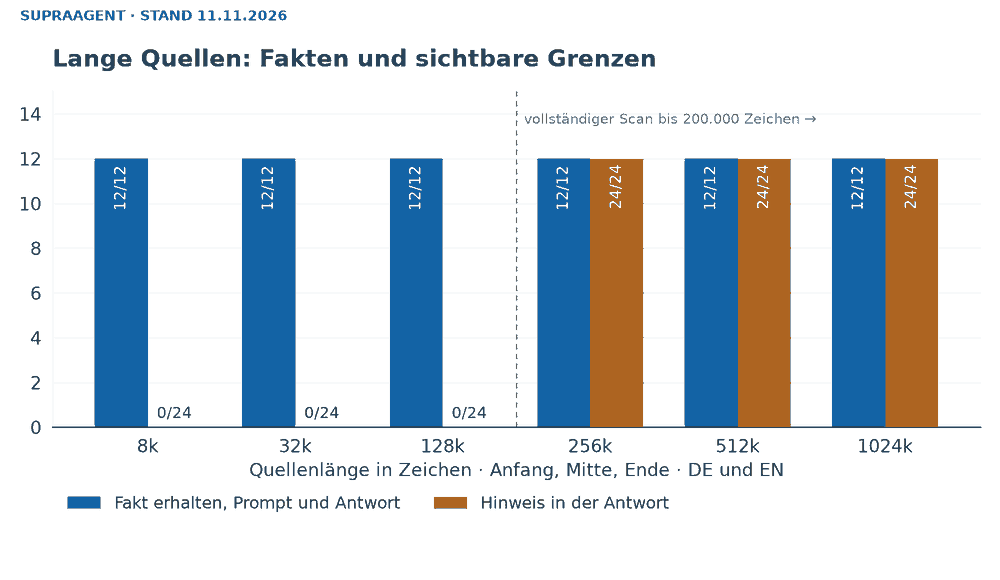
3. Lange Quellen: erhaltene Fakten und Hinweise je Länge, Anfang, Mitte und Ende, Deutsch und Englisch.
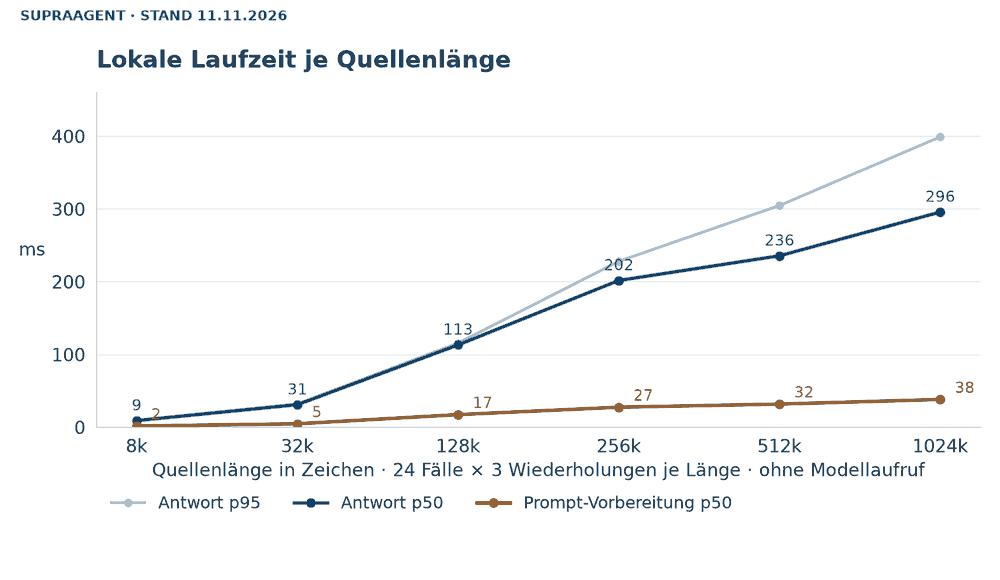
4. Lokale Laufzeit je Quellenlänge, 24 Fälle × 3 Wiederholungen je Länge, ohne Modellaufruf und Produktions-I/O.
Kontext-Fixtures: Quellen-Recall je Suchverfahren
Verfahren | Quellen-Recall (5 Fälle) | Faktenpräsenz (4 Fälle) |
|---|---|---|
BM25 | 65 % | 50 % |
Hash-Vektoren | 65 % | 50 % |
Graph, 1 Hop | 90 % | 75 % |
Graph, 3 Hops | 100 % | 100 % |
Hybrider Graph | 100 % | 100 % |
Drei Graph-Hops finden in diesen kleinen, selbst verfassten Fixtures jede erwartete Quelle und jeden Referenzfakt. Das ist eine Integrationsdiagnose: wörtliche Faktenpräsenz belegt keine Schlussfolgerung, und synthetische benchmark.invalid-Adressen sind Testkennungen.
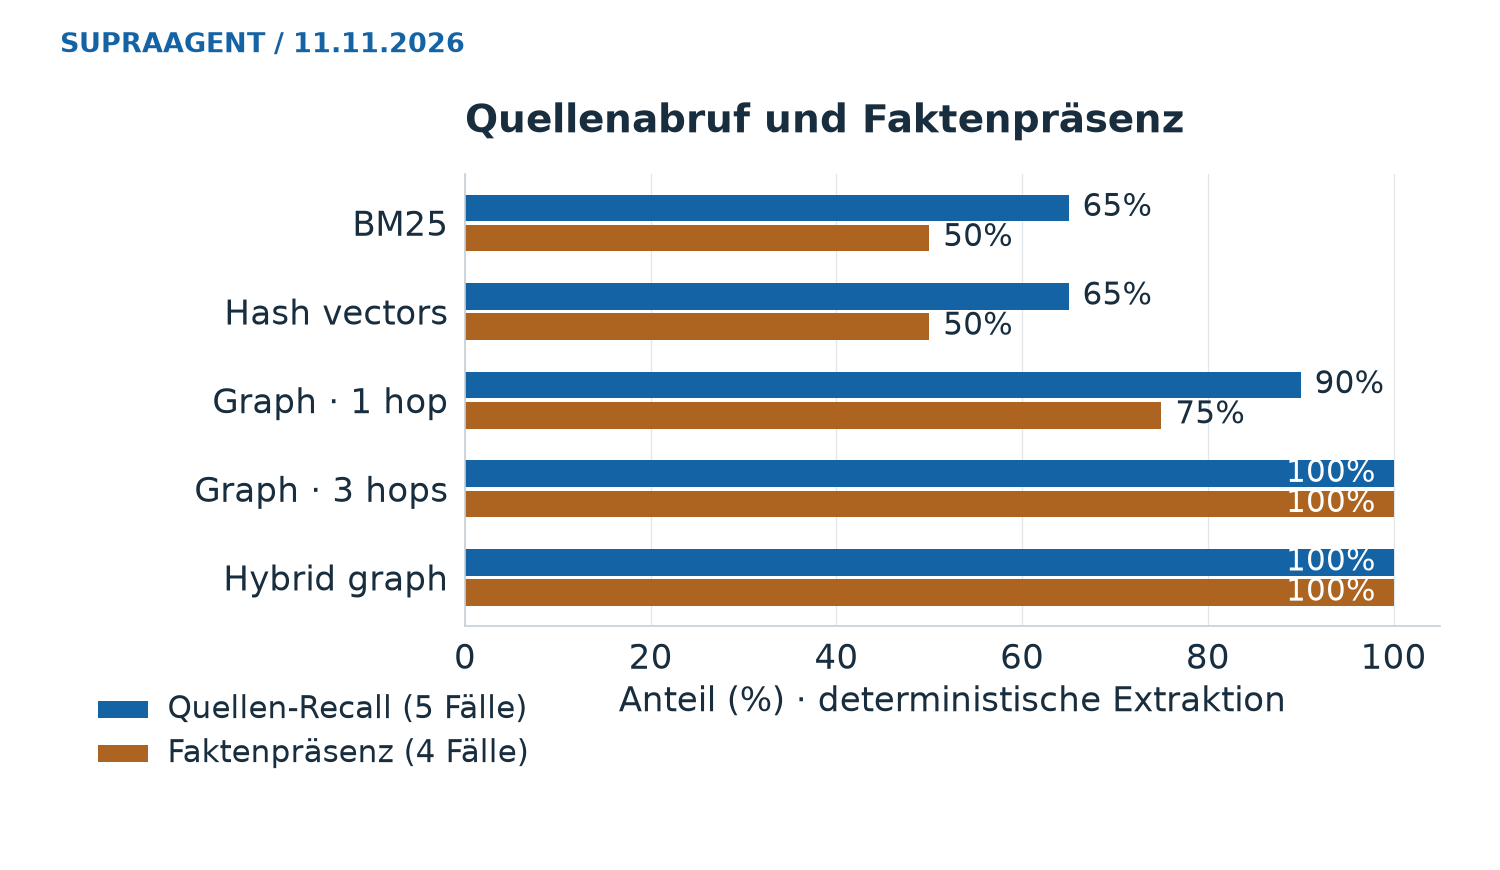
5. Kontext-Fixtures: Quellen-Recall über fünf annotierte Fälle und wörtliche Faktenpräsenz über vier Fälle. Misst keine semantische Korrektheit.
Was Quellenlinks belegen
Jede numerische Quellenmarkierung im Modul-Replay löst auf eine zugelassene Quellen-ID auf, mit null verlorenen oder unaufgelösten Markierungen über alle 576 Läufe. Die Auflösung von Quellen-IDs ist strukturell, keine semantische Quellenstützung. Antwortkorrektheit, Übersetzungsqualität, Supportnutzen und Prozesserfolg bleiben ohne unabhängige Bewertung ungemessen.
Begutachtete Methodik
Das Design folgt begutachteten Arbeiten; jede DOI wurde über Crossref verifiziert. Die Arbeiten leiten die Messungen und zertifizieren SupraAgent nicht.
Robertson, Zaragoza und Taylor (CIKM 2004), Simple BM25 extension to multiple weighted fields: Feldgewichtung für den Abschnittstitel.
Robertson und Zaragoza (2009), The Probabilistic Relevance Framework: BM25 and Beyond: das Scoring-Modell und seine Statistiken je Dokument.
Craswell et al. (WSDM 2008), An experimental comparison of click position-bias models: warum die zuerst gelistete Quelle gesondert gemessen wird.
Card, Robertson und Mackinlay (CHI 1991), The information visualizer: die 0,1-Sekunden-Wahrnehmungsschwelle zum Lesen der lokalen Laufzeit.
Liu et al. (TACL 2024), Lost in the Middle: Position der Belege in langen Kontexten.
Bai et al. (ACL 2024), LongBench: warum Faktenerhalt über Zeichenlängen kein Modellverständnis ist.
Gao et al. (EMNLP 2023), ALCE: Antwortqualität und Zitatqualität sind getrennt.
Amershi et al. (CHI 2019), Guidelines for Human-AI Interaction: Grenzen in der Antwort sichtbar machen.
Lewis et al. (NeurIPS 2020), Retrieval-Augmented Generation: Suche und Generierung werden als getrennte Stufen berichtet.
Yao et al. (ICLR 2025), tau-bench: Prozessleistung braucht Ergebnisprüfungen gegen den resultierenden Zustand, die dieser Benchmark nicht ausführt.
Nachweise, Reproduktion und Grenzen
Berichte, archivierte Quellen, Rohantworten, Abbildungen und Reproduktionsbefehle liegen im Nachweispaket (GitHub-Zugang erforderlich). Das Paket friert Quell-Hashes vor und nach jedem Lauf ein und ist mit SHA-256 gefingerprintet; 1.133 fokussierte Tests bestehen auf dem gemessenen Code. Wiederholungen und Übersetzungspaare sind abhängig, daher wird keine Signifikanz behauptet.
Eine Qualitätsaussage auf Produktebene bräuchte zusätzlich unabhängig bewertete Antworten und Quellenstützung, frische Holdout-Fragen aus Kundendomänen, eine menschliche Bewertung der Nutzererfahrung, Produktionslatenz unter Last und isolierte Prozessläufe mit geprüftem Vorher-Nachher-Zustand. Bis dahin stützt dieser Benchmark konkrete Such-, Erhalt- und Regressionsdiagnosen. Er belegt keine allgemeine Genauigkeit, keine erfolgreichen Live-Prozesse und keine Überlegenheit gegenüber anderen Agenten.